
15. Juli 2026
Bei Idealo verkaufen: Der Guide für Händler
Anmeldung, Kosten, Datenfeed und Ranking: Was Händler wissen müssen, bevor sie ihre Produkte auf Idealo listen – Schritt für Schritt erklärt.
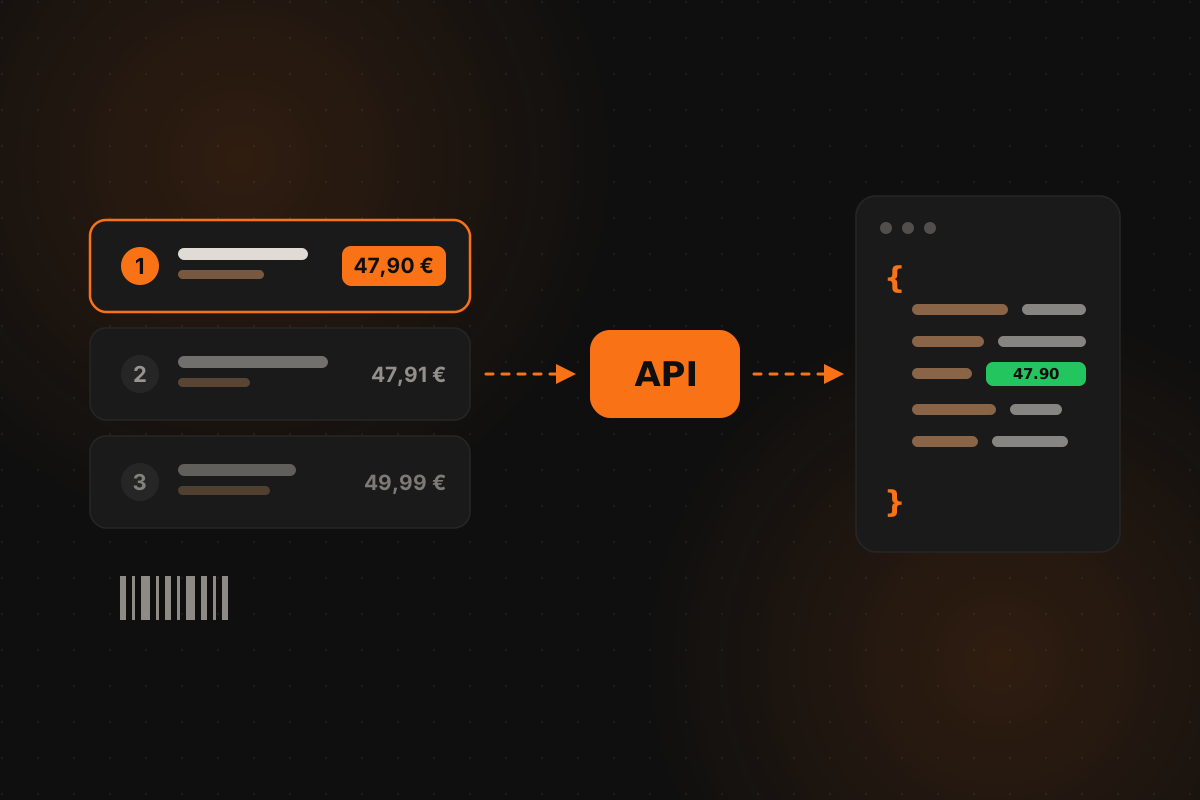
Wer nach einer „Idealo API” sucht, will fast immer dasselbe: die Angebotsdaten eines Idealo-Listings – alle Anbieter mit Preis, Versandkosten und Position – programmatisch abrufen, statt sie von Hand aus dem Browser abzulesen. Die Anwendungsfälle reichen von Konkurrenzbeobachtung über eigene Repricing-Logik bis zu BI-Dashboards und Pricing-Modellen.
Dafür gibt es drei Wege, und sie werden ständig verwechselt: die offizielle Idealo-Schnittstelle (PWS), die etwas völlig anderes tut, als die meisten erwarten; ein selbst gebauter Scraper, der einfacher aussieht, als er ist; und eine fertige Price Data API, die Idealo-Listings als strukturiertes JSON liefert. Dieser Artikel erklärt alle drei – inklusive der Frage, wie Idealo-Scraping technisch überhaupt funktioniert und woran es in der Praxis scheitert.
Ein Idealo-Listing ist eine sortierte Liste von Angeboten verschiedener Händler für dasselbe Produkt. Eine brauchbare API muss diese Liste vollständig und strukturiert abbilden:
Ein Detail, das bei der Interpretation der Daten oft falsch verstanden wird: Idealo sortiert die Angebotsliste nach dem Artikelpreis, nicht nach dem Gesamtpreis. Die Versandkosten fließen nicht in die Sortierung ein – sie werden aber direkt beim Angebot hervorgehoben, sodass Käufer den Gesamtpreis sofort sehen. Wer Positionsdaten auswertet oder eine eigene Preislogik baut, braucht deshalb beide Werte getrennt: Der Artikelpreis bestimmt die Position, der Gesamtpreis beeinflusst die Kaufentscheidung. (Warum die Position so viel Umsatz entscheidet, lesen Sie im Guide Idealo Repricing.)
Idealo bietet Händlern eigene Schnittstellen an, dokumentiert unter dem Namen PWS (Partner Web Services). Wer bei der Suche nach „Idealo API” oder „Idealo Business API” dort landet, erwartet meist Preisdaten – und wird enttäuscht: Die PWS ist eine Verwaltungsschnittstelle für Ihre eigenen Angebote. Händler nutzen sie, um ihre Produktdaten und Preise zu Idealo zu übertragen.
Was die PWS nicht beantwortet, ist die Frage, die hinter fast jeder Suche nach einer Idealo API steckt: Was bieten alle anderen Händler auf einem Listing an – zu welchem Preis, mit welchen Versandkosten, auf welcher Position? Diese Wettbewerbssicht stellt Idealo über keine öffentliche Schnittstelle bereit. Das gilt übrigens auch für die anderen Preisvergleiche im deutschsprachigen Raum: Weder Geizhals noch billiger.de bieten eine öffentliche Preisdaten-API an.
Wer die Wettbewerbsdaten braucht, hat also nur zwei Optionen: selbst scrapen oder eine fertige API nutzen.
Die Grundidee eines Scrapers ist schnell erklärt – und ein erster Prototyp ist an einem Nachmittag gebaut. Der Weg von dort zu einer zuverlässigen Datenpipeline ist allerdings weit. Schauen wir uns die Bausteine der Reihe nach an.
Im Kern lädt ein Scraper die HTML-Seite eines Listings und zieht die gewünschten Werte mit CSS-Selektoren heraus. In JavaScript übernimmt das typischerweise Cheerio, in Python Beautiful Soup. Vom Prinzip her sieht das so aus:
import * as cheerio from "cheerio";

const html = await fetch(
  "https://www.idealo.de/preisvergleich/OffersOfProduct/201846460"
).then((r) => r.text());

const $ = cheerio.load(html);

$('[class*="productOffers-listItem"]').each((i, el) => {
  const shop = $(el).find('[class*="OfferShop"]').text().trim();
  const preis = $(el).find('[class*="OfferPrice"]').first().text().trim();
  console.log(i + 1, shop, preis);
});
Die Selektoren in diesem Beispiel sind bewusst als Muster geschrieben, denn genau hier beginnt die Wartungsarbeit: Idealo verändert die Seitenstruktur laufend. Klassennamen ändern sich, Elemente werden verschachtelt, Angebotsblöcke umgebaut. Jede dieser Änderungen bricht den Scraper – meist unbemerkt, bis jemand die Datenqualität prüft. Selektoren nachpflegen wird damit zum Dauerbetrieb.
Wer viele Anfragen von derselben IP-Adresse sendet, wird schnell blockiert. Scraper verteilen ihre Anfragen deshalb über rotierende Proxies: Jede Anfrage (oder jede Session) läuft über eine andere IP.
Dabei gibt es zwei Klassen von Proxies, und der Unterschied ist für Idealo entscheidend:
Für Idealo führt an Residential-Proxies praktisch kein Weg vorbei; mit Datacenter-IPs ist nach wenigen Anfragen Schluss.
Weil Residential-Proxies nach Bandbreite abgerechnet werden, wird jedes unnötig geladene Byte zum Kostenfaktor. Eine Produktseite zieht neben dem HTML auch Bilder, Schriften, Stylesheets und Skripte nach – ein Vielfaches der Datenmenge, die der Scraper eigentlich braucht. Produktions-Scraper blockieren deshalb alle Ressourcen außer dem HTML-Dokument selbst und halten so die Kosten pro abgefragtem Listing in einem vertretbaren Rahmen. Das erfordert allerdings, den Abruf über einen steuerbaren Browser oder einen Request-Interceptor zu führen – ein weiteres bewegliches Teil in der Pipeline.
Selbst mit sauberen Selektoren, Residential-Proxies und optimierter Bandbreite bleibt das größte Risiko: Idealo wird von Akamai geschützt, einem der aufwendigsten Bot-Erkennungssysteme am Markt. Akamai bewertet nicht nur die IP-Adresse, sondern das Gesamtbild einer Anfrage – Browsereigenschaften, Verbindungsmerkmale, Verhaltensmuster – und stellt verdächtigen Clients Challenges, die ein einfacher Scraper nicht besteht.
Das Entscheidende daran: Diese Erkennung entwickelt sich ständig weiter. Ein Scraper, der heute zuverlässig läuft, kann nächste Woche flächendeckend blockiert werden, weil Akamai ein neues Erkennungsmuster ausgerollt hat – ohne Ankündigung und ohne dass sich am eigenen Code irgendetwas geändert hätte. Realistisch ist Idealo-Scraping deshalb kein Projekt, das man einmal abschließt, sondern ein Wettlauf mit offenem Ausgang: Es funktioniert, bis es erkannt wird, und dann beginnt die Arbeit von vorn.
Am Ende besteht ein selbst gebauter Idealo-Scraper aus vier Baustellen gleichzeitig: Selektoren pflegen, ein Residential-Proxy-Netz betreiben und bezahlen, Bandbreite optimieren und auf jede Änderung der Bot-Erkennung reagieren. Jede einzelne davon ist lösbar. Alle vier zusammen sind ein dauerhaftes Engineering-Projekt – für ein Ergebnis, das trotzdem jederzeit ausfallen kann. Für ein Hobby-Projekt mit einer Handvoll Produkte mag sich das lohnen. Sobald Preisdaten zuverlässig in Geschäftsprozesse fließen sollen, kippt die Rechnung.
Die Idealo API von PricePirate dreht das Verhältnis um: Sie senden einen Identifikator und bekommen das Listing als geprüftes, strukturiertes JSON zurück. Selektoren, Proxies, Bandbreite und Bot-Erkennung sind nicht mehr Ihr Problem. Abgerechnet wird pro erfolgreichem Ergebnis – fehlgeschlagene Abfragen kosten nichts.
Als Startpunkt dient der Identifikator, den Sie ohnehin schon haben:
| Operation | Eingabe | Typischer Einsatz |
|---|---|---|
search-by-gtin | EAN / GTIN / UPC | Eigene Produkte eindeutig nachschlagen |
search-by-id | Idealo-Produkt-ID | Bekannte Listings regelmäßig abfragen |
search-by-term | Suchbegriff | Listings zu einem Produkt erst finden |
search-by-url | Idealo-Produkt-URL | Listings aus vorhandenen Links auflösen |
shop-info | Idealo-Shop-ID | Shop-Profile mit Bewertungen und Top-Produkten |
Abgedeckt sind sechs Länder – Deutschland, Österreich, Spanien, Frankreich, Italien und Großbritannien –, und jeder Lookup fragt das Listing live ab, statt veraltete Datenbestände auszuliefern. Wer neben Idealo weitere Quellen braucht, findet in der Price Data API dieselbe Abfragelogik auch für Google Shopping, Amazon, Klarna und Allegro.
Idealo-Preisdaten in Minuten statt als Dauerprojekt? Testen Sie die Idealo Price Data API auf Apify – mit kostenlosem Startkontingent, ohne Setup.
In den meisten Fällen ist der Barcode der praktischste Einstieg: Jedes Handelsprodukt trägt eine GTIN (8–14 Stellen, kompatibel mit EAN, UPC und JAN), und die steht in jedem Warenwirtschaftssystem und jedem Shopify-Export. Ein GTIN-Lookup ordnet Ihre Produkte eindeutig den Idealo-Listings zu – ohne fehleranfälliges Titel-Matching und ohne manuelle Listenpflege.
Nicht jedes Produkt hat allerdings eine eigene Idealo-Produktseite. Landet ein Barcode-Lookup stattdessen auf einer Such- oder Kategorieseite, prüft ein KI-Modell jedes gefundene Angebot gegen verifizierte Produktdaten: Jedes Angebot trägt dann eine classification – etwa same_variant, different_product oder multipack – samt Konfidenz. So liefern auch Produkte verwertbare Ergebnisse, die früher leer zurückkamen, und Sie entscheiden selbst, wie streng Sie die Treffer filtern.
Ein Abruf besteht aus drei Feldern – bis zu 50 Werte auf einmal:
{
  "operation": "search-by-gtin",
  "values": ["4009803341163", "4014835778306"],
  "country": "de"
}
Pro Wert kommt ein Ergebnis zurück: das Produkt mit Name, Bild und Preisspanne sowie alle sichtbaren Angebote. Gekürzt sieht das so aus:
{
  "product": {
    "name": "Beispielprodukt 500 ml",
    "ean": "4009803341163",
    "url": "https://www.idealo.de/preisvergleich/OffersOfProduct/201846460"
  },
  "offers": [
    {
      "shop_name": "beispielshop.de",
      "position": "1",
      "price": 47.9,
      "shipping": 4.95,
      "total": 52.85,
      "currency": "EUR",
      "shop_review_rating": 4.8,
      "shop_review_count": 1243,
      "availability_text": "Sofort lieferbar",
      "classification": "same_variant"
    }
  ]
}
Artikelpreis, Versand und Gesamtpreis kommen getrennt zurück – Sie sehen also sowohl die Größe, nach der Idealo sortiert, als auch den Betrag, den der Käufer am Ende vergleicht. Damit steht die Datengrundlage für Preisanalysen, Marktbeobachtung und eigene Repricing-Logik. Die vollständige Dokumentation aller Operationen finden Sie auf der Idealo-API-Seite.
Für Händler ja – die PWS. Sie verwaltet aber ausschließlich Ihre eigenen Angebote. Eine öffentliche Idealo-Schnittstelle für die Wettbewerbssicht – alle Angebote eines Listings mit Preisen und Positionen – gibt es nicht; dafür braucht es eine Price Data API wie die von PricePirate.
Bei PricePirate zahlen Sie pro erfolgreichem Ergebnis; fehlgeschlagene Abfragen kosten nichts. Zum Ausprobieren gibt es ein kostenloses Startkontingent, die aktuellen Konditionen stehen im Apify-Listing. Für hohe Kontingente und direkte Anbindung gibt es Enterprise-Konditionen ab 615 € pro Monat.
Nein. Ein kostenloses Apify-Konto genügt – damit senden Sie Ihre erste Abfrage in wenigen Minuten. Alternativ steht die API auch auf RapidAPI bereit.
Jeder Lookup fragt das Listing live ab. Die Ergebnisse liegen typischerweise nach ein bis zwei Minuten vollständig vor – es gibt keinen zwischengespeicherten Datenbestand, der veralten könnte.
Die offizielle PWS beantwortet die Preisdaten-Frage nicht, und ein eigener Scraper beantwortet sie nur so lange, bis Selektoren, Proxies oder die Bot-Erkennung die Pipeline stoppen. Wenn Idealo-Preisdaten zuverlässig verfügbar sein sollen, ist eine fertige API der kürzeste und kalkulierbarste Weg:
Und wenn Sie Preise nicht nur lesen, sondern automatisch anpassen wollen: Genau dafür gibt es Idealo Repricing mit PricePirate.
PricePirate ist ein unabhängiges Produkt der UCX Media und steht in keiner geschäftlichen, partnerschaftlichen oder sonstigen Verbindung zur idealo internet GmbH.
15. Juli 2026
Anmeldung, Kosten, Datenfeed und Ranking: Was Händler wissen müssen, bevor sie ihre Produkte auf Idealo listen – Schritt für Schritt erklärt.
25. August 2026
Vom TikTok Shop zum eigenen Onlineshop mit Idealo-Traffic: Wie der Parfüm-Händler Levamour mit automatischem Repricing seine Conversion-Rate verdoppelt hat.

29. Mai 2026
Bezahlte Idealo-Klicks ohne Verkäufe? Wie Preisposition, Preisparität, Produktseite und Checkout Ihre Conversion-Rate bestimmen – mit Benchmarks vs. Google Shopping.